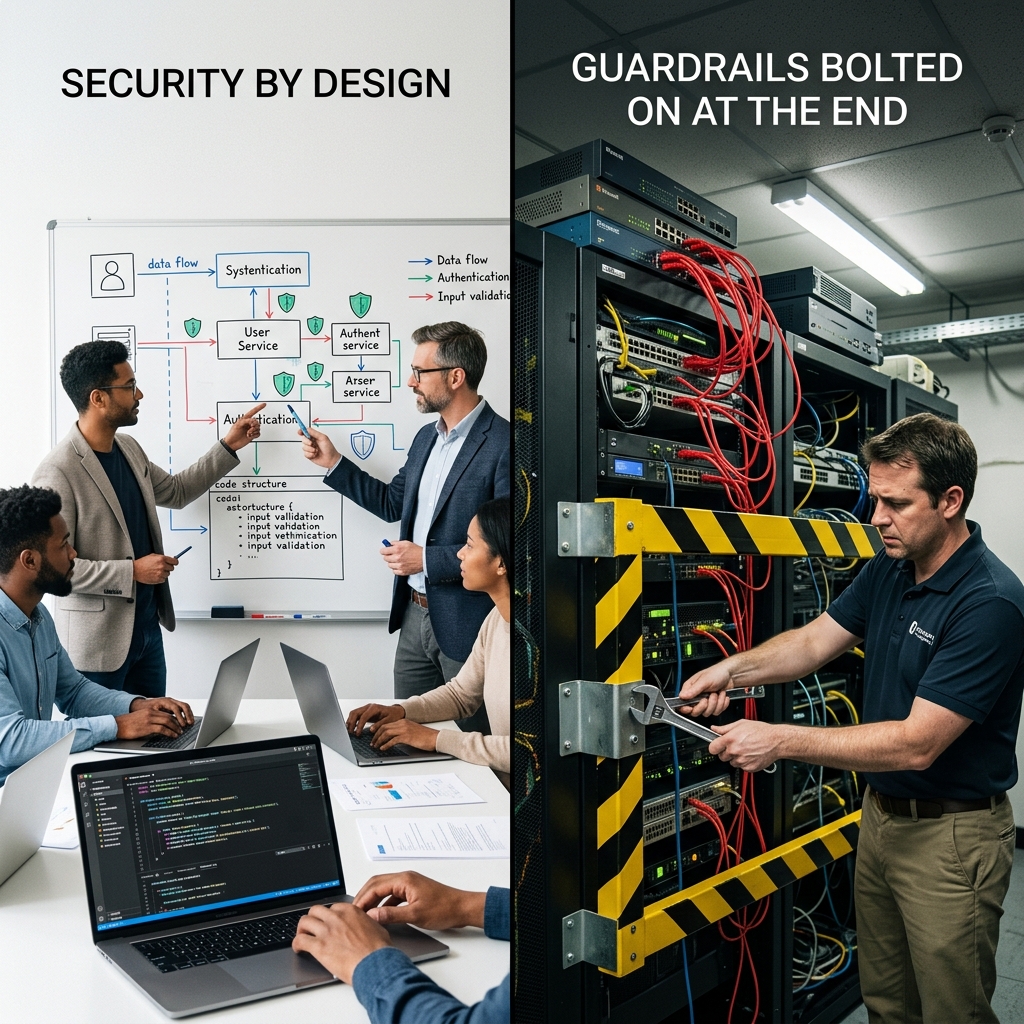
A segurança de um sistema baseado em IA é definida durante a fase de projeto, ou não é definida de todo: o que é adicionado no final são mitigações parciais de decisões já tomadas. Uma proteção que filtra respostas não corrige um modelo de permissões mal projetado, assim como um corrimão não corrige os alicerces.
A diferença entre as duas formas de trabalhar não reside na segurança. Reside no custo, e é enorme: o que custa uma conversa de duas horas antes de começar pode custar um projeto inteiro mais tarde.
Decisão | Se tomado no início | Se você tentar adicioná-lo mais tarde |
|---|---|---|
Que identidade o sistema usa para acessá-lo? | Configuração | Refazer integrações e modelo de permissões |
Que ações você pode realizar? | Lista fechada desde o início | Auditar e limitar o código já em produção. |
O que é registrado para cada execução? | Instrumentação desde o primeiro dia | O passado não pode ser reconstruído. |
Separação de ambientes | Estrutura do projeto | Migração em risco de interrupção |
Onde residem e quem processa os dados | Escolha da arquitetura | Renegociação de contrato e migração |
A terceira linha possui uma propriedade que a torna especialmente cara: É irreversível.. Se não foi registrado, não existe. Quando um cliente, um auditor ou um tribunal perguntar o que o sistema fez três meses atrás, a resposta não dependerá da disposição de cooperar, mas de uma decisão técnica que alguém tomou — ou deixou de tomar — antes de começar.
É importante ser preciso, pois este artigo poderia ser interpretado como uma crítica às medidas de segurança, o que não é o caso. Filtrar conteúdo inadequado, detectar padrões de manipulação conhecidos e limitar o tamanho das respostas são medidas úteis.
O que eles não conseguem fazer é conter os danos estruturais. Uma proteção atua sobre o texto que entra e sai; ela não atua sobre o que o sistema pode fazer. Se o sistema tem permissão para processar um pagamento, nenhum filtro de conteúdo impede que esse pagamento seja processado quando algo leva o sistema a tomar essa decisão.
A hierarquia correta é esta:
A ordem importa. Começar pelo ponto 4 é o mais comum, pois é o que se pode comprar; começar pelo ponto 1 é o que funciona, pois é o que você projeta.
Estas são as perguntas que nos fazemos antes de escrever código em qualquer projeto com componentes de IA:
Com qual identidade o sistema acessa cada fonte? A resposta correta é quase sempre: com o usuário, propagado.
Qual é a lista fechada de ações que podem ser realizadas? Listado, não descrito. O que não está listado não existe.
Que ações são irreversíveis e quem as valida? Pagamentos, comunicações externas, alterações na produção e tudo o que afete dados de terceiros.
O que é gravado, onde e por quanto tempo? Com detalhes suficientes para reconstruir um caso específico meses depois.
Que dados entram no sistema e que dados são excluídos por decisão explícita? O princípio "caso você precise" é a origem da maioria das exposições.
Como interromper e reverter esse processo? Um mecanismo que não exige a implantação de código nem depende do provedor.
Seis perguntas, uma reunião. É a intervenção com a melhor relação custo-benefício de todo o projeto, e é a que mais é deixada de lado porque durante a semana todos querem ver algo funcionando.
O argumento contrário é sempre o mesmo e é razoável: existe pressão para mostrar resultados e a segurança atrasa o processo.
A resposta útil não é apelar para o risco abstrato, mas oferecer uma alternativa concreta: um alcance menor com o design completo. Em outras palavras, não se trata de reduzir a segurança para cumprir o prazo, mas sim de reduzir o escopo funcional e manter intactas as seis decisões.
Um sistema que executa três tarefas bem, com permissões e rastreabilidade limitadas, pode ser expandido. Um sistema que executa trinta tarefas sem controle precisa ser reconstruído antes de poder ser expandido, e a essa altura já existem usuários dependendo dele.
A pressa não é inimiga da segurança. O escopo, sim.
Trata-se de tomar decisões de segurança — identidade de acesso, ações permitidas, registro de logs, separação de ambientes e residência de dados — durante a fase de projeto, e não após a construção. Essas decisões são baratas inicialmente, mas muito caras para modificar quando o sistema já está em produção.
Para filtrar conteúdo inadequado, detectar padrões de manipulação conhecidos e limitar formatos de resposta. O que elas não fazem é conter danos estruturais: atuam sobre o texto de entrada e saída, não sobre o que o sistema pode executar com as permissões concedidas.
Seis: com qual identidade o sistema acessa cada fonte, qual é a lista fechada de ações permitidas, quais ações são irreversíveis e quem as valida, o que é registrado e por quanto tempo, quais dados são excluídos por decisão explícita e como o sistema é interrompido e revertido.
Porque é irreversível: se não foi registrado, a informação não existe. Quando um cliente, auditor ou tribunal perguntar o que o sistema fez meses atrás, a capacidade de responder dependerá de uma decisão técnica tomada antes mesmo de o sistema começar a funcionar.
A estrutura de gerenciamento de riscos de IA do NIST baseia-se na capacidade de identificar, medir e controlar; a norma ISO/IEC 42001 exige comprovação de controle contínuo para certificação; e o Regulamento Europeu de IA exige registro de eventos, documentação técnica e supervisão humana demonstrável para determinadas categorias.
Reduzir o escopo funcional, não as decisões de design. Um sistema que executa três tarefas bem, com permissões e rastreabilidade limitadas, pode ser expandido; já um que executa trinta tarefas sem controle precisa ser redesenhado antes da expansão, principalmente quando os usuários já dependem dele.
Você vai iniciar um projeto de IA? A conversa de duas horas sobre identidade, permissões, ações e cadastro é o investimento mais valioso de todo o projeto. Faremos isso com você, sem compromisso. Vamos conversar → |