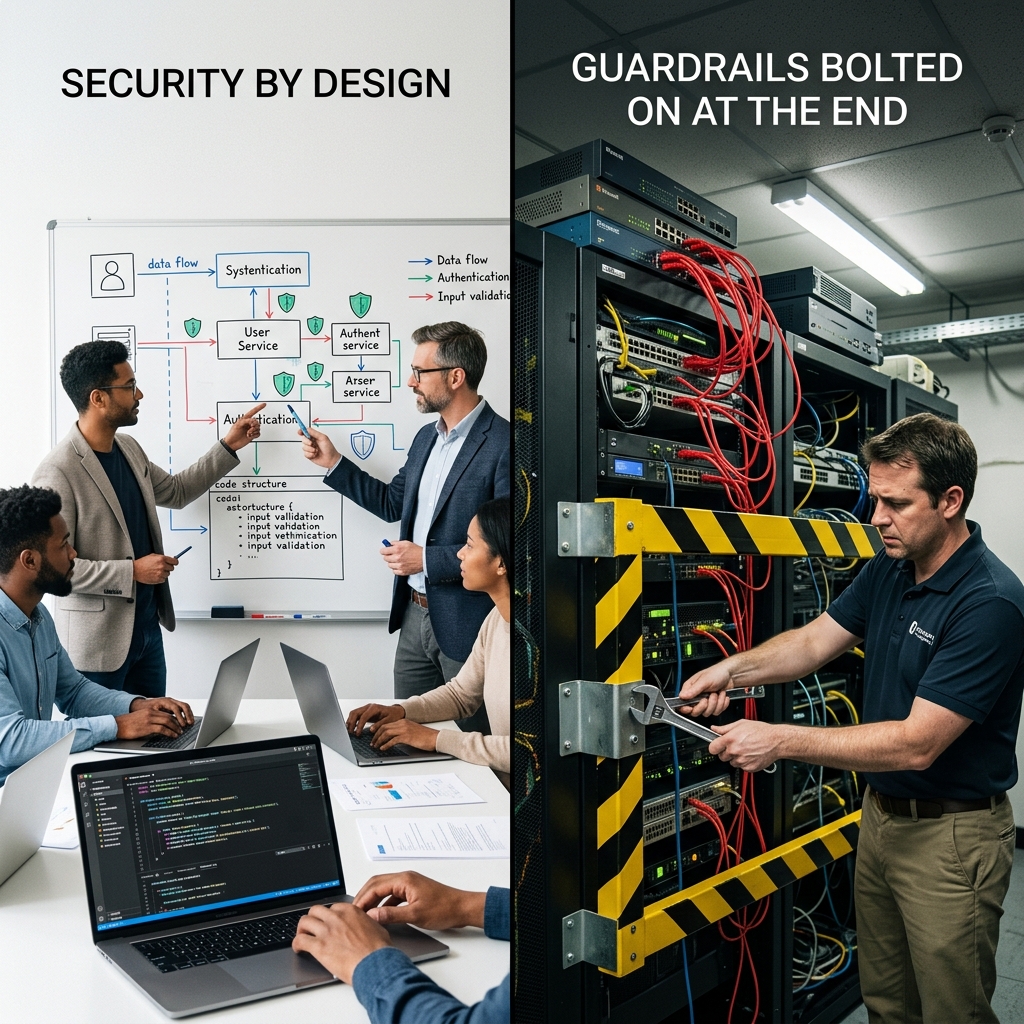
La seguridad de un sistema con inteligencia artificial se decide en la fase de diseño o no se decide: lo que se añade al final son mitigaciones parciales sobre decisiones ya tomadas. Un guardarraíl que filtra respuestas no arregla un modelo de permisos mal planteado, igual que una barandilla no corrige los cimientos.
La diferencia entre las dos formas de trabajar no es de nivel de seguridad. Es de coste, y es enorme: lo que cuesta una conversación de dos horas antes de empezar puede costar un proyecto entero después.
Decisione | Si se toma al principio | Si se intenta añadir después |
|---|---|---|
Con qué identidad accede el sistema | Configuración | Rehacer integraciones y modelo de permisos |
Qué acciones puede ejecutar | Lista cerrada desde el inicio | Auditar y limitar código ya en producción |
Qué se registra de cada ejecución | Instrumentación desde el primer día | No se puede reconstruir el pasado |
Separación de entornos | Estructura del proyecto | Migración con riesgo de interrupción |
Dónde residen y quién trata los datos | Elección de arquitectura | Renegociación contractual y migración |
La tercera fila tiene una propiedad que la hace especialmente costosa: es irrecuperable hacia atrás. Si no se registró, no existe. Cuando un cliente, un auditor o un tribunal pregunte qué hizo el sistema hace tres meses, la respuesta no dependerá de la voluntad de colaborar, sino de una decisión técnica que alguien tomó —o no tomó— antes de empezar.
Conviene ser preciso, porque este artículo puede leerse como un desprecio a los guardarraíles y no lo es. Filtrar contenido inapropiado, detectar patrones de manipulación conocidos o limitar la longitud de una respuesta son medidas útiles.
Lo que no hacen es contener el daño estructural. Un guardarraíl actúa sobre el texto que entra y sale; no actúa sobre lo que el sistema puede hacer. Si el sistema tiene permiso para ejecutar un pago, ningún filtro de contenido impide que ese pago se ejecute cuando algo consigue que el sistema decida hacerlo.
La jerarquía correcta es esta:
El orden importa. Empezar por el punto 4 es lo habitual porque es lo que se puede comprar; empezar por el 1 es lo que funciona porque es lo que se diseña.
Estas son las preguntas que planteamos antes de escribir código en cualquier proyecto con componentes de IA:
¿Con qué identidad accede el sistema a cada fuente? La respuesta correcta casi siempre es: con la del usuario, propagada.
¿Cuál es la lista cerrada de acciones que puede ejecutar? Enumerada, no descrita. Lo que no está en la lista, no existe.
¿Qué acciones son irreversibles y quién las valida? Pagos, comunicaciones externas, cambios en producción y cualquier cosa que afecte a datos de terceros.
¿Qué se registra, dónde y durante cuánto tiempo? Con el detalle suficiente para reconstruir un caso concreto meses después.
¿Qué datos entran en el sistema y cuáles quedan fuera por decisión explícita? El «por si acaso lo necesita» es el origen de la mayoría de las exposiciones.
¿Cómo se detiene y cómo se revierte? Un mecanismo que no requiera desplegar código ni depender del proveedor.
Seis preguntas, una reunión. Es la intervención con mejor relación coste-beneficio de todo el proyecto, y es la que más veces se salta porque en la semana uno todo el mundo quiere ver algo funcionando.
El argumento contrario siempre es el mismo y es razonable: hay presión por enseñar resultados y la seguridad ralentiza.
La respuesta útil no es apelar al riesgo abstracto, sino ofrecer la alternativa concreta: un alcance más pequeño con el diseño completo. Es decir, no reducir la seguridad para llegar a la fecha, sino reducir el alcance funcional y mantener las seis decisiones intactas.
Un sistema que hace tres cosas bien, con permisos acotados y trazabilidad, se puede ampliar. Un sistema que hace treinta cosas sin control hay que rehacerlo antes de poder ampliarlo, y para entonces ya hay usuarios dependiendo de él.
La prisa no es enemiga de la seguridad. Lo es el alcance.
Es tomar las decisiones de seguridad —identidad de acceso, acciones permitidas, registro, separación de entornos y residencia de datos— durante el diseño y no después de construir. Son decisiones que resultan baratas al principio y muy costosas de modificar una vez el sistema está en producción.
Para filtrar contenido inapropiado, detectar patrones de manipulación conocidos y limitar formatos de respuesta. Lo que no hacen es contener el daño estructural: actúan sobre el texto que entra y sale, no sobre lo que el sistema puede ejecutar con los permisos que tiene concedidos.
Seis: con qué identidad accede el sistema a cada fuente, cuál es la lista cerrada de acciones permitidas, qué acciones son irreversibles y quién las valida, qué se registra y durante cuánto tiempo, qué datos quedan fuera por decisión explícita, y cómo se detiene y se revierte el sistema.
Porque es irrecuperable hacia atrás: si no se registró, la información no existe. Cuando un cliente, un auditor o un tribunal pregunte qué hizo el sistema hace meses, la capacidad de responder dependerá de una decisión técnica tomada antes de empezar.
El NIST AI RMF estructura la gestión de riesgo sobre la capacidad de identificar, medir y controlar; la ISO/IEC 42001 requiere evidencia de control continuo para certificar; y el Reglamento europeo de IA impone registro de eventos, documentación técnica y supervisión humana demostrable para determinadas categorías.
Reduciendo el alcance funcional, no las decisiones de diseño. Un sistema que hace tres cosas bien con permisos acotados y trazabilidad se puede ampliar; uno que hace treinta sin control hay que rehacerlo antes de ampliarlo, cuando ya hay usuarios dependiendo de él.
¿Vas a empezar un proyecto con IA? La conversación de dos horas sobre identidad, permisos, acciones y registro es la inversión más rentable de todo el proyecto. La hacemos contigo, sin compromiso. Parliamone → |